非侵入式脑机接口解码精度实现突破,神经解码准确率最高可达 78%
摘 要
Meta(原Facebook)近期公布迭代升级的非侵入式脑机接口系统Brain2Qwerty v2,可直接捕捉人脑活动信号并智能解码生成完整文字,系统整体单词解码准确率达61%,其中最优受试者准确率可达78%,超半数解码句子误差不超过一个单词。
实测数据结果远超过往非侵入式方案8%的行业平均水平,为大幅降低脑机交互的落地门槛和非侵入式脑机接口技术路径提供了新的思路。
几乎是同时段,Meta去年发布的Brain2Qwerty v1版本,登上了Nature Neuroscience。
连续两年,Meta FAIR(Facebook AI Research)实验室(Meta超级智能实验室)与西班牙巴斯克认知、大脑与语言中心(Basque Center on Cognition, Brain and Language,BCBL)坚持发布Brain2Qwerty系列研究成果,标志着非侵入式脑机接口(Non-invasive BCI)技术解码语言能力正在逐级跃迁。
v1版本以32%的平均字符错误率(Character Error Rate,CER)登顶《Nature Neuroscience》(最优表现是字符错误率约19%),证明了基于脑磁图(Magnetoencephalography,MEG)的深度学习解码在自然语句生产任务中的可行性;而v2版本更进一步,将平均单词准确率提升至61%,最佳受试者达78%,实现了从“逐字符拼凑”到“端到端语义解码”的质变。
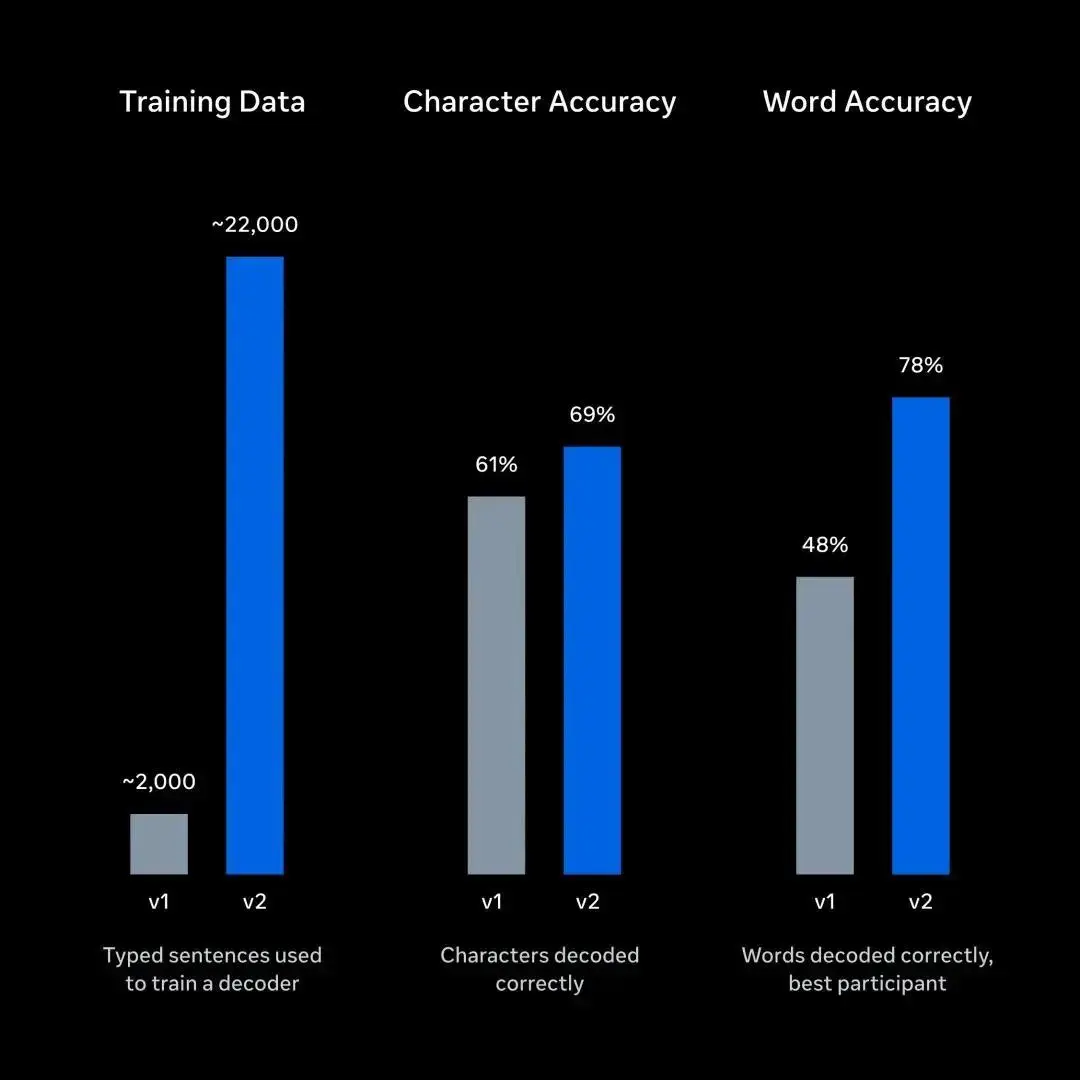
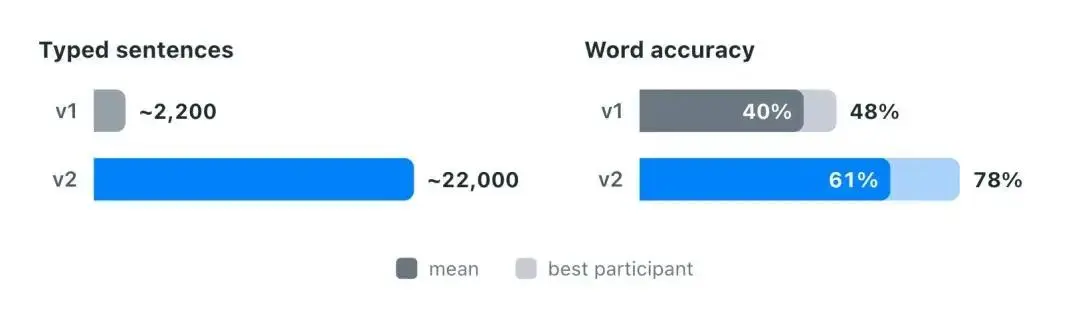
值得关注的是,Meta选择将v1和v2的全部训练代码开源,BCBL同步开放v1数据集。这一“开放共享”的姿态不仅加速了学术界的复现与迭代,向产业界传递了一个明确信号:非侵入式脑机接口的核心瓶颈正在从“算法架构”转向“数据规模与质量”,而解决这一瓶颈需要构建开放协作的生态系统。
01 v1到v2 由“字符识别”到“语义生成”
Brain2Qwerty v1采用卷积模块、转换器模块和语言模型三阶段架构:卷积模块(Convolutional Module)负责从500ms时间窗口的MEG/EEG信号中提取特征,转换器模块(Transformer Module)在句子级别进行上下文建模,最后预训练语言模型(Pretrained Language Model)进行统计校正。这一架构本质上仍属于“字符级分类”范式——模型预测的是每个按键对应的字符,再通过语言模型进行后处理纠错。
v2则实现了架构层面的根本性重构,采用“Conformer-Encoder-Aligner-LLM”三段式端到端设计,提升对 “字母 — 单词 — 句子” 的解码能力。
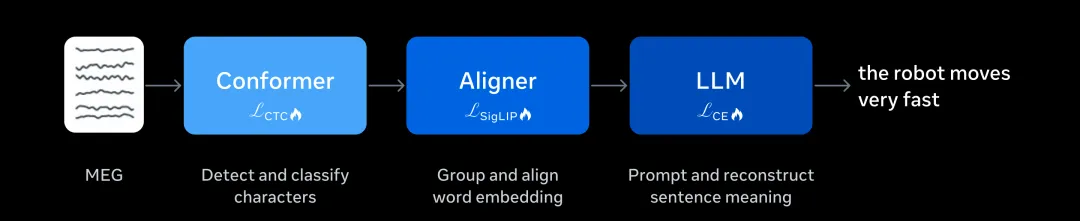
整条流水线分为Brain Encoder和NeuroLLM两块,Brain Encoder将原始脑磁信号压缩为字符神经序列,NeuroLLM在Brain Encoder输出之上接入Qwen3-4B,基于语义连贯性最终输出自然语言句子。
这些模块替换,实际是深层解码逻辑的转变:v1的解码目标是“还原按键动作”,v2的解码目标则是“还原语言意图”。也就是说v2的端到端架构使模型能够捕捉更高层次的语言表征,而非局限于低级运动皮层的按键映射,为未来从“运动想象”甚至“纯语言想象”中解码文本奠定基础。
不过,传统MEG设备依赖超导量子干涉仪(Superconductivity QUantum Interference Device,SQUID),需要液氦冷却和磁屏蔽室,体积庞大、成本高昂,难以走出实验室。研究团队也坦承,当前系统尚不能直接用于临床。这一现实约束提示我们:非侵入式BCI的临床转化,取决于算法进步与硬件形态的双重革新。
02 打破天花板 重新“认识”非侵入式脑机接口
在Brain2Qwerty之前,非侵入式脑机接口在语言解码领域长期处于“基本不可用”的状态——解码准确率、信息传输速率、用户体验感三者都无法达到应用需求。而Brain2Qwerty v2将非侵入式语句解码的单词准确率从行业此前最佳的约8%提升至研究中的平均61%,跳过渐进式改良,直接完成数量级的跨越。
这一突破对于全行业而言,意义在于:它证明了非侵入式信号——至少在MEG层面——蕴含的语言信息远超此前认知。长久以来,侵入式脑机接口路径一直在解码准确率上有着天然优势,然而需要开颅手术,面临出血、感染、长期电极退化等风险,令人望而却步。
Brain2Qwerty系列以“无创”为前提,将性能差距从“无法逾越的天堑鸿沟”缩小为“可通过工程技术手段追赶的差距”,为大规模临床部署提供了理论可行性。
此外,Brain2Qwerty v2将LLM引入神经解码流程,代表了脑机接口领域与生成式人工智能深度融合的趋势。这一融合揭示了神经解码的本质挑战:大脑信号是极度稀疏、高噪声、非平稳的,单纯依靠信号处理难以达到临床可用精度;而大语言模型所蕴含的万亿级语义先验知识,可以有效弥补神经信号中的信息缺失。
这种协同机制,为非侵入式脑机接口指明了一条现实路径:即使颅外信号损失了大部分神经信息,只要捕捉到与语言意图相关的“微弱痕迹”,AI模型就可以利用其强大的语义推理能力重建完整内容。当然,要提醒的是,根据国家药品监督管理局于2026年6月30日发布的《脑机接口医疗器械产品分类界定指导原则》,按照第三类医疗器械管理。
更为重要的是,Meta选择开源全部训练代码、BCBL开放数据集,这一决策对于产业来说具有深远的影响。众所周知的是,在BCI领域,数据壁垒一直是制约学术和产业进步的核心瓶颈:神经数据采集成本高、隐私敏感、标准化程度低,导致大多数研究团队“各自为战”。Brain2Qwerty的这次开源策略可以说是打破了这一僵局,使得全球研究者可以在统一的数据和代码基础上进行迭代创新,加速技术收敛。
03 高质量可信数据空间 脑机接口产业发展的生态基础
对于中国企业而言,这既是一次技术追赶的机遇,也是一次生态卡位的挑战。开源代码降低了算法研发的门槛,但数据资产的积累仍需依靠本土化的临床采集网络。谁能率先构建符合中国人群神经特征、覆盖汉语语言体系的大规模脑电数据库,谁就能在开源浪潮中占据价值链上游。
对于以“脑电数据中心为引擎、脑电算法为驱动”的江苏博而雅科技有限公司,这一技术演进路径与产业逻辑体现出深刻的启示意义更值得反复揣摩学习。
Brain2Qwerty v2研究明确揭示:神经解码性能随数据规模对数线性增长,且在现有数据范围内未达饱和。这意味着,数据是当下非侵入式脑机接口技术最核心的战略资源,其重要性甚至超过算法架构的创新。
博而雅科技在建的“长三角多模态融合高质量脑电可信数据空间”,正是面向这一趋势的前瞻性基础设施。与Meta依赖BCBL单中心采集不同,博而雅科技的“政产学研医”模式能够整合医院临床场景、高校科研能力、产业工程化经验和政府政策支持,形成持续、规模化、多模态的数据采集与标注能力。
特别是在汉语语言体系下,神经解码面临与印欧语系完全不同的挑战,本土化的数据中心具有不可替代的价值。
目前,企业研发团队正在尝试借鉴Brain2Qwerty的跨被试训练策略,探索“基础解码模型+个体微调”的技术路线,利用可信数据空间积累的大规模多中心、多任务脑电数据,预训练跨被试共享的“基础模型”,再针对特定患者进行少量数据的个性化适配。这不仅能提升模型泛化能力,还能显著降低新用户的校准时间,为临床转化创造商业可行性。
04 以数据规模化治理 逐步呈现行业非线性效应
鉴于Brain2Qwerty v2的性能-数据曲线尚未出现平台期,这表示我们仍处于“数据红利”的早期阶段。参照大语言模型的发展轨迹,当神经解码数据从百小时级跃升至万小时级、从单中心扩展至多中心、从健康人群覆盖至多样患者群体时,可能会出现类似“涌现能力”(系统规模达到临界点后,突然展现出小规模时不具备的新能力)的质变——例如,模型突然具备跨语言迁移、跨任务泛化、甚至零样本适配的能力。
这为博而雅科技的可信数据空间建设预留了巨大想象空间:以数据规模化为性能驱动力,以开源生态为加速器,逐步实现“脑电数据中心+脑电算法”的飞轮效应。
在脑机接口这个通往未来的技术上,数据是燃料,算法是引擎,而开放协作的生态,则是行业持续加速发展的最佳通路。博而雅科技将抓住此次技术平权机遇,持续发挥独特的场景优势和数据优势,在非侵入式算法、多模态融合、以及数据生态构建方面发力,加速构建长三角乃至全国脑机接口企业赖以生长的生态基础。